这是什么项目?
一个围绕机器人模仿学习搭建的研究与竞赛工作区。模型从人类提供的机器人示范中学习动作,再在仿真中检验任务完成能力。主要开发仓库是 lingbot-vla-v2-lazyteam/,包含官方模型实现与 FASTV 实验改动。
Git HEAD:f1acb77;本次生成介绍页不改训练源码。
从三路相机和文字指令生成双臂动作:这里汇集 LingBot-VLA 2.0 的模型结构、训练流程、RoboTwin 闭环评测,以及剪枝实验的权重、指标与展示材料。
模型加载、真实前向反向、短训练与单回合闭环已有通过记录。动作时间 padding 合同仍失败;本轮正式长训练与全量评测未启动。
依据 PROJECT_STATE.md 与 r5 模型准入审计。历史成绩单独标注。
一个围绕机器人模仿学习搭建的研究与竞赛工作区。模型从人类提供的机器人示范中学习动作,再在仿真中检验任务完成能力。主要开发仓库是 lingbot-vla-v2-lazyteam/,包含官方模型实现与 FASTV 实验改动。
Git HEAD:f1acb77;本次生成介绍页不改训练源码。
历史实验 来自归档的 8,000 步训练与 50×20 回合评测;本机 smoke 验证少量步骤和回合能否运行;当前准入 检查正式运行前的合同。
历史报告、文件实际可用性和当前验证状态分别列出,避免把单回合成功或旧成绩当成新一轮全量结果。
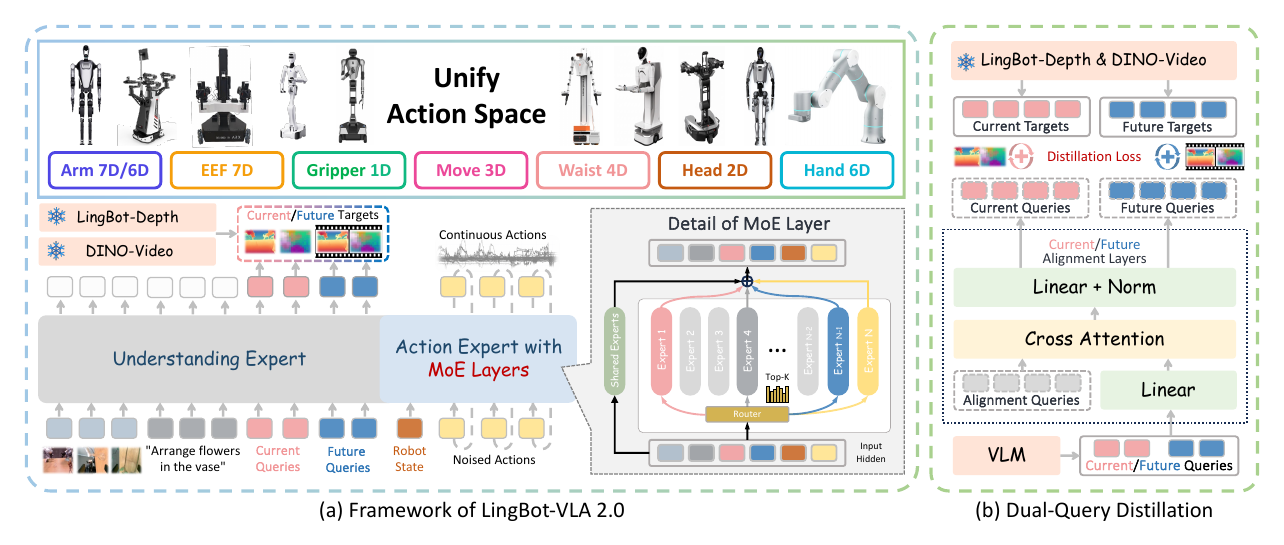
视觉语言主干理解场景,动作专家结合机器人状态生成未来 50 步动作。
state 经投影后进入动作流(suffix)。prefix 的注意力无法读取 suffix,因此当前结构中机器人状态直接影响动作专家,视觉语言主干不受 state 条件化。
55 维表示预留手臂、末端位姿、夹爪、灵巧手、腰部、头部、移动底盘等字段。RoboTwin 的 12 个臂关节与 2 个夹爪值由 robot config 映射到其中,其他位置补零。
Flow Matching 训练预测动作与噪声之间的速度;推理从随机噪声出发迭代生成动作。当前采样验证完成 10/10 次速度调用,动作专家每层路由到 32 个专家中的 4 个。
实现:V2 模型 · robot config
冻结的 MoGe、LingBot-Depth / MoRGBD 与 DINO-Video 教师提供当前、未来几何与语义特征。主干中的感知 query 通过对齐 head 学习这些特征,再由动作专家消费。
辅助监督在历史 8,000 步训练中持续启用。visual_steps: 5000 是可视化日志间隔。查询扰动会改变动作,但缺少开关对照的闭环实验,尚不能量化成功率收益。
对齐蒸馏记录 · 本地完整权重含 84 个对齐相关张量。
| 资产 | 核对结果 | 在流程中的作用 |
|---|---|---|
| LeRobot v3.0 数据 | 2,500 episodes / 548,893 frames | 真实轨迹为 25 个 Parquet;语言条目 2,411 条,不等于操作类别数量。 |
| 三路相机视频 | 25 个 MP4 · AV1 · 240×320 · 15 FPS | 顶部、左腕、右腕观察;训练前还有 resize 与 processor 处理。 |
| 归一化统计 | bounds_99_woclip | 使用仓库提供的 robotwin 统计;历史说明记载其来自官方混合语料。 |
| LingBot-VLA 完整预训练权重 | 6 个 FP32 分片 · 1,708 张量 | 约 63.76 亿参数元素;作为后训练起点,已通过已有 strict loader 验证。 |
| Qwen3-VL 目录 | 仅配置、tokenizer、processor 元数据 | 主干权重从完整 VLA checkpoint 中加载。 |
训练与仿真使用独立环境,通过策略服务连接,避免依赖版本相互冲突。
hf_ckpt/。入口:train_lingbotvla.py;优化器支持 Muon、Distributed Muon、AdamW 等路径。
部署:策略服务;开环脚本另提供动作 MSE / MAE。
runtime/robotwin-eval-code/,兼容源版本为 7303c97。| 主要目录 | 职责 | 当前用法 |
|---|---|---|
lingbot-vla-v2-lazyteam/ | 模型、数据变换、训练、部署、FASTV 实验 | 主要源码仓库,训练入口与模型类位于这里。 |
RoboTwin/ | 较新上游,scripts / XPolicyLab 体系 | 和当前兼容评测版本的入口、数据格式有差异。 |
RoboTwin-compat-7303c97/ | 旧版兼容工作树与场景资产 | 当前评测依赖这一版本,资产被 runtime 副本复用。 |
runtime/ | 本机适配、配置、日志、checkpoint、审计 | 查看本轮实际验证与资产可用性。 |
datasets/ / models/ | 轨迹和视频 / 预训练权重与教师 | 提供离线训练、推理资产。 |
competition_material/ | 灵波 2026 提交模板 | 要求 clean 训练入口、两种 setting 的评测入口及改动说明;模板尚未填写。 |
先回答最关心的三个问题,再看剪枝机制和实测收益。
在索引 2 的主干层后,以接收注意力质量给视觉 patch 打分,删除低分 token。索引从 0 起,对应第三层;最多采样 128 个 query 行进行打分。
语言、视觉边界、深度与视频查询保留。示例 prefix 从 286 缩短到 190;后续主干层和缓存处理更短序列。
有历史训练记录,也有本机 smoke 权重。8,000 步模型记录完整,但本机权重目录缺失。第 1、2 步 FASTV checkpoint 实际存在,属于链路验证产物。
历史 8k 模型:clean 62.80%,randomized 33.60%,各 50×20 回合。本机第 2 步模型仅做 click_bell 单回合 smoke,1/1 成功。
未找到 FASTV 策略执行录像。历史评测关闭了视频,本机 smoke 也未录制。可展示真实训练示范片段和官方任务 GIF,均标明来源与用途。
torch.compile;当前部署验证走 eager。keep_ratio: 1.0 可作为关闭剪枝的对照配置。| 测量 | 关闭 FASTV | 开启 FASTV | 变化 / 结论 |
|---|---|---|---|
| 视觉 token / prefix 长度 | 192 / 286 | 96 / 190 | 视觉 token 减半,prefix 减少 33.6% |
| 端到端训练步时中位数 | 9.758 s | 9.008 s | 1.083× 加速;耗时减少约 7.7% |
| 末 200 步动作损失均值 | 0.0674 | 0.0692 | 归档相对差异 +2.60% |
| 单卡纯 forward | 0.3863 s | 0.4066 s | 0.950×,没有测到加速 |
| 单卡 forward + backward | 1.2814 s | 1.2971 s | 0.988×,没有测到加速 |
| 计算隔离峰值显存 | 20.45 GiB | 20.45 GiB | 该测量下无下降 |
核对文件系统、导出索引和运行配置。下面三种资产用途不同。
global_step_8000
clean-only + FASTV;8×A100 PCIe、global batch 128。归档记录每 1,000 步保存,累计 8 组 checkpoint。
完整历史权重未随文本归档迁入。outputs/robotwin_clean50_fastv 为目标不存在的符号链接,页面不提供无效下载。
/project-data/lingbot_fastv/robotwin_clean50_fastv/checkpoints/global_step_8000/hf_ckptglobal_step_1
8 卡短训练第一步;保存配置确认 fastv_keep_ratio: 0.5,run 回执 PASS。
3 个 safetensors 分片,config 与索引存在,约 11.88 GiB 导出权重。用于保存与加载链路验证。
runtime/runs/lingbot-vla-official-short-20261003-r4/checkpoints/global_step_1/hf_ckptglobal_step_2
从第一步 checkpoint 接续;启用 FASTV 0.5,已用于 click_bell 单回合闭环 smoke。
3 个 safetensors 分片,config 与索引存在,约 11.88 GiB 导出权重。两步训练不构成收敛模型。
runtime/runs/lingbot-vla-official-resume-smoke-20261003/checkpoints/global_step_2/hf_ckptmodels/lingbot-vla-v2-6b/ 的 6 个分片在本地。这是 FASTV 后训练的初始化权重,不是历史 8,000 步 clean-only 实验的最终权重。部署需要 hf_ckpt/ 及对应训练目录的 lingbotvla_cli.yaml;断点恢复则需要 DCP 的 model / optimizer / extra_state。此处核对分片是否齐全,没有重新对大权重做完整哈希校验。
历史 8k 模型只用 clean_50 训练,开启 FASTV,评测采用 FP32;每种 setting 各 1,000 回合。
50 任务 × 20 回合;原始统计逐任务行与汇总数已复算一致。置信区间沿用归档值。这不是本轮 canonical 成绩。
这只验证一个任务的一个 seed 能运行并成功,无法估计 50 任务成功率,也不能与历史 FP32 benchmark 等同比较。
动作损失 0.3457 → 0.0198;总损失 0.3770 → 0.0237。原始 CSV 每 25 步采样,曲线并非每步原始记录。移动指针查看样本值。
50 个任务,每个 setting 均为每任务 20 回合。
| 任务 | Clean | Randomized | Clean − Randomized |
|---|
负差值表示 randomized 成绩更高。每任务样本仅 20 回合,逐任务差异不等同于已确认的因果效应。
页面提供真实可播放素材,同时明确区分训练示范、官方场景展示和模型执行录像。
历史评测使用 --no_video;本机单回合 smoke 使用 --eval_video_log False,回执仅列出 eval_results/click_bell/_result.txt。日志记录成功,仍不能替代实际录像。
历史评测脚本 · 本机 smoke 脚本 · 素材来源清单
本地 LeRobot 数据的 episode 0。三个机位来自同一回合,抽取原始 139 帧并转为浏览器兼容的 H.264 MP4。
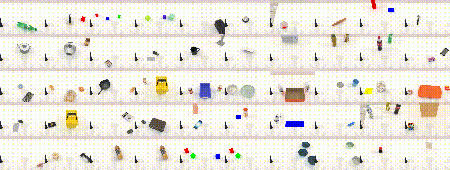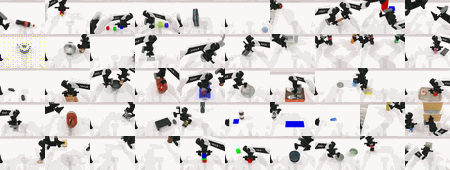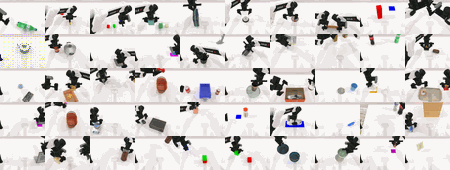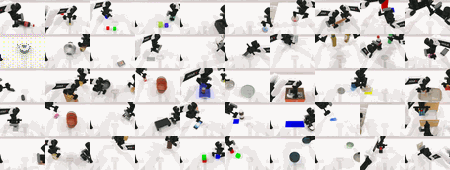
仓库自带的任务展示 GIF,用于说明仿真平台包含的任务类型,不代表 FASTV checkpoint 的能力。
下载任务 GIF · 原文件 RoboTwin/assets/files/50_tasks.gif
最新 r5 保留完整对齐监督与 FASTV。下列问题依据现存审计,不是本页新增的模型实验。
| 准入阶段 | 状态 | 实际验证 |
|---|---|---|
| 00_preflight | PASS | 依赖、CUDA、完整 checkpoint、processor、真实数据与教师资产。 |
| 01_loader | PASS | 6B strict loader 与完整 alignment 权重。 |
| 02_real_batch_backward | PASS | 真实 episode-tail batch、真实教师目标、BF16 前向反向。 |
| 03_action_is_pad | FAIL | 真实 pad 位从 49 改为 48,loss 与记录梯度不变。 |
| 04_sample_actions | PASS | eager + cache,10/10 速度调用,输出 [1,50,55] 且 finite。 |
| 05_grid_safety | PASS | 仅在关闭 precompute_grid_thw 的 overlay 下通过。 |
模型 wrapper 接受 action_is_pad,但损失只使用 joint_mask。关节维度补零与动作窗口末端时间 padding 是两个不同问题。真实尾部 batch 的标记扰动实验已确认当前路径不敏感。
开启预计算时,网格 A→B 会继续使用旧 split sizes 并触发错误。目前使用 precompute_grid_thw: false 后相同验证通过;源码缓存问题仍存在。
门禁区分 smoke 与 canonical,并检查任务、回合、seed、进程退出码、日志哈希、setup / inference failure 以及汇总算术。已有 14 项单元测试通过记录;历史 50×20 不能按本轮 50×100 正式结果使用。
查看 evaluation_gate.py部分脚本硬编码历史 /root/... 与 Conda 路径,本机适配主要在 runtime/job-scripts。比赛模板尚未填写,完整历史权重和策略录像也没有迁入。
没有。历史消融比较每侧 2,000 步的训练损失和耗时,并未给两侧模型做完整闭环成功率对照。历史 8k 成绩属于 FASTV 开启的一个训练配方,不能单独证明剪枝对成功率无影响。
不能简单将 align_params 清空。完整 checkpoint 含对齐模块,strict post-training loader 会拒绝多余权重。进行消融需要保留加载兼容性,并明确改变哪一部分计算与监督。
两步训练权重主要用来验证分布式更新、保存、恢复和服务链路。一回合成功不构成收敛证据,也不能用于估计正式多任务成绩。
当前数据管道中的未来图像用于训练期教师监督。模型通过当前 prefix 的感知查询预测相关特征,部署采样使用当前相机画面、文字与机器人状态,不需要真实未来图像。
介绍页中的指标、checkpoint 与媒体都有本地来源;页面内容为静态快照。
本轮当前状态与正式运行边界。
模型总体设计、官方配置与引用成绩。
历史 clean-only + FASTV 实验档案。
历史训练、消融与两个 setting 的汇总。
重要性、token 选择、KV cache 剪枝。
训练接线、采样、MoE 与损失汇总。
分布式训练、教师监督与 checkpoint。
LeRobot 数据、robot config 与归一化。
padding 失败与 grid 配置缓解。
示范片段对应的源视频、episode、帧数与用途。
python3 assets/build_snapshot.py,会重新核对历史表格算术、两组本机权重索引、媒体清单,并更新嵌入的数据和 JSON。介绍性文字、图片和转码片段需要在项目变化时一并更新。